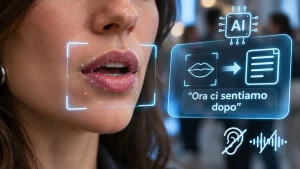
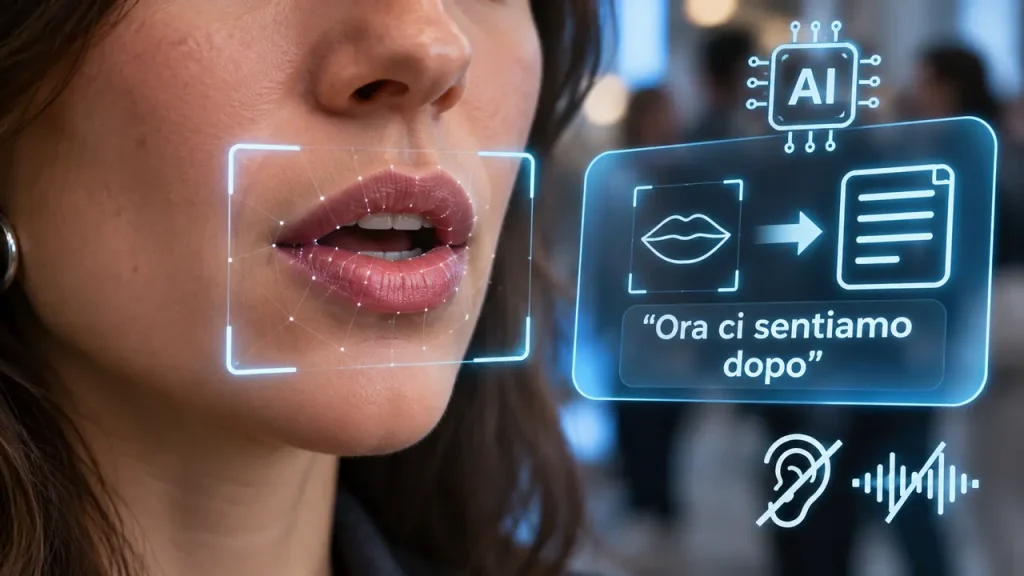
Non serve più ascoltare una conversazione per sapere che cosa si stanno dicendo due persone. Potrebbe bastare osservare il movimento delle loro labbra, almeno secondo i ricercatori del Korea Advanced Institute of Science and Technology (KAIST), che hanno sviluppato un sistema di intelligenza artificiale capace di riconoscere le parole attraverso la sola analisi delle immagini.
La tecnologia si chiama DLLM-VSR e rappresenta un importante passo avanti nel campo della lettura labiale automatizzata. Il sistema è infatti in grado di analizzare un video senza audio e ricostruire le frasi pronunciate dalle persone riprese, raggiungendo risultati particolarmente interessanti nei test di laboratorio. Secondo i dati pubblicati dai ricercatori, il tasso di errore nel riconoscimento delle parole si ferma al 19,4%, un risultato che costituisce un nuovo primato tra i sistemi addestrati con la stessa quantità di dati etichettati.
Un’intelligenza artificiale che non legge una parola alla volta
Leggere le labbra è un’operazione molto più complicata di quanto si possa immaginare. Numerosi suoni, come quelli associati alle lettere “p”, “b” e “m”, producono movimenti della bocca praticamente identici. Senza poter ascoltare la voce, distinguere una parola dall’altra diventa quindi particolarmente difficile.
Per superare questo ostacolo, i ricercatori sudcoreani hanno adottato un approccio diverso rispetto ai tradizionali sistemi di riconoscimento vocale. DLLM-VSR utilizza un modello linguistico a diffusione, che non cerca di interpretare le parole una dopo l’altra, seguendo necessariamente l’ordine della frase. Il sistema individua inizialmente quelle che riesce a riconoscere con maggiore sicurezza e sfrutta il contesto per ricostruire progressivamente le parti mancanti.
In pratica, l’intelligenza artificiale considera l’intera frase, utilizzando le informazioni presenti sia prima sia dopo una parola per stabilire quale sia l’interpretazione più probabile. Un procedimento che permette di limitare gli errori che, nei sistemi tradizionali, rischiano di propagarsi lungo tutta la trascrizione.
Il software valuta inoltre diverse possibili lunghezze delle frasi sulla base della durata del filmato, confronta le trascrizioni generate e seleziona quella ritenuta più attendibile. I risultati sono stati ottenuti utilizzando 433 ore di video per l’addestramento e il benchmark LRS3, uno dei riferimenti utilizzati nella ricerca sul riconoscimento del linguaggio attraverso le immagini.
Dalle fabbriche agli occhiali intelligenti: le possibili applicazioni
Una tecnologia del genere potrebbe trovare applicazione in numerosi contesti. Si pensi, per esempio, agli ambienti industriali particolarmente rumorosi, dove il funzionamento dei macchinari rende difficile comunicare verbalmente. Ma le prospettive più interessanti riguardano soprattutto l’accessibilità per le persone sorde o con difficoltà uditive. Un dispositivo capace di leggere le labbra e trasformare immediatamente le parole in testo potrebbe facilitare le conversazioni quotidiane, anche in situazioni nelle quali gli attuali strumenti di riconoscimento vocale risultano poco efficaci.
I ricercatori stanno lavorando proprio in questa direzione, cercando di ridurre la potenza di calcolo necessaria al funzionamento del sistema. L’obiettivo è arrivare a una tecnologia utilizzabile in tempo reale su dispositivi indossabili e robot, anche senza una connessione a Internet.
Per il momento, tuttavia, DLLM-VSR rimane un progetto sperimentale. Le prestazioni cambiano a seconda dei filmati analizzati e il sistema necessita ancora di ulteriori ottimizzazioni prima di poter essere impiegato in prodotti destinati al grande pubblico.
E la privacy? L’IA potrebbe ascoltarci anche senza microfono
Come spesso accade con le tecnologie più innovative, accanto alle opportunità emergono anche alcuni rischi. Un’intelligenza artificiale capace di ricostruire una conversazione attraverso un video silenzioso potrebbe trasformarsi in uno strumento di sorveglianza particolarmente invasivo. In teoria, sarebbe possibile tentare di interpretare le parole pronunciate da una persona anche quando non esiste alcuna registrazione audio.
Naturalmente, il sistema attuale è ancora lontano dal garantire una trascrizione perfetta in qualsiasi condizione. La qualità delle immagini, l’inquadratura del volto e la visibilità delle labbra rimangono fattori determinanti.
La ricerca del KAIST dimostra comunque quanto rapidamente stiano evolvendo le capacità dell’intelligenza artificiale. E apre uno scenario nel quale per comprendere quello che diciamo potrebbe non essere più necessario ascoltare la nostra voce.